
AI热点|千问开源 Qwen-Image-2.1:7B 参数把生图与改图装进同一个模型,原生透明图层首次并入
 发布时间:2026-09-21
 浏览:0 次
9月20日,阿里千问团队在 Hugging Face、ModelScope 与 GitHub 同步开源了 Qwen-Image-2.1。这是一款把文生图与图像编辑合并进同一模型的图像基础模型,视觉生成部分只有 7B 参数,官方给它的定位是"兼顾生成效果、推理效率与使用成本"的开源图像模型。在当天多家 AI 日报中,它被列为最具共识的一条技术发布。
一、7B 装下一整套生成能力:轻量结构的工程取舍
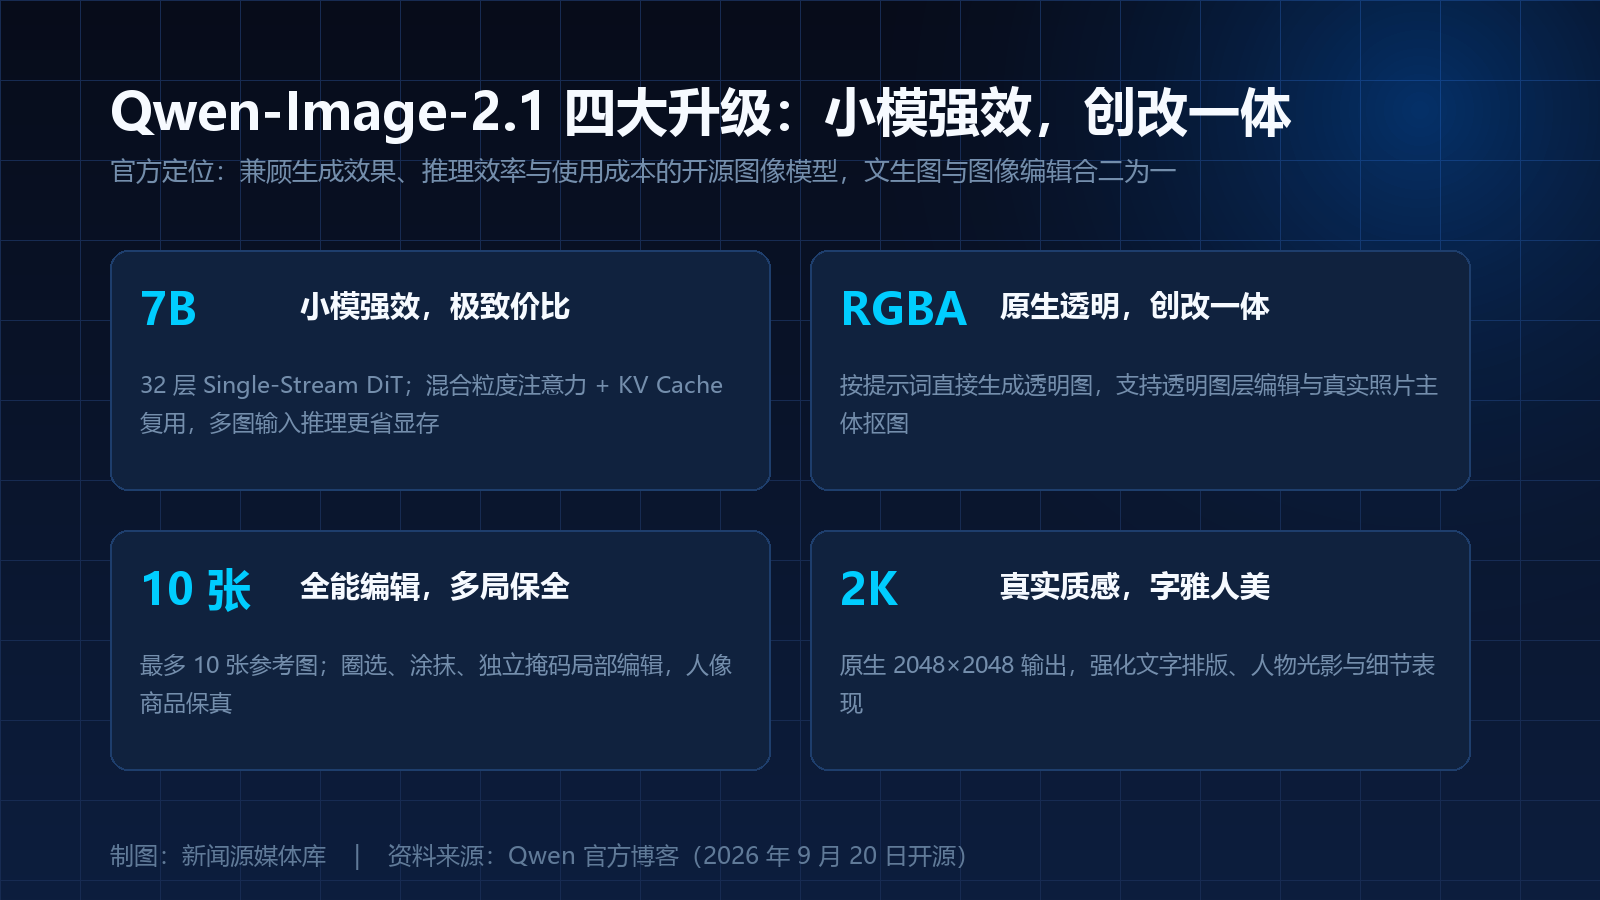
Qwen-Image-2.1 的视觉生成部分由 32 层 Single-Stream DiT 构成,参数量为 7B,配合 Qwen3-VL 8B 文本编码器与 64 通道 RGBA VAE,可原生输出 2048×2048 分辨率图像。为了让"小模型"扛住多图输入的算力压力,团队引入了混合粒度注意力结构:文本部分(系统前缀与编辑指令)采用 Token 级因果掩码,图像生成部分采用 Chunk 级掩码;同时通过 KV Cache 复用机制,把输入图像与编辑指令作为静态上下文在首步预计算并缓存,从而降低显存开销。这套设计释放的信号很明确——在图像模型赛道上,参数规模的边际收益正在下降,推理成本的边际影响正在上升。
二、原生透明:从"专门模型"到"统一模型"
透明图像是本次更新最受关注的能力。千问曾在 2025 年 12 月发布 Qwen-Image-Layered 专门支持透明图像生成,如今这项能力被直接整合进统一模型:模型可以根据提示词自动判断输出普通图像还是带透明通道的图像,也支持在保留透明背景的前提下直接编辑主体,例如修改人物表情、替换透明图层中的文字;对真实照片,模型能提取指定主体并输出 RGBA 图层,方便后续设计与合成。对电商、设计与素材生产来说,这意味着"抠图"这一步正在被推进入模型内部。
三、全能编辑:10 张参考图与"选区式"修改
编辑能力被官方概括为"多、局、保、全"四个方向:最多支持 10 张参考图输入,可综合多个主体生成完整画面;支持圈选、涂抹与独立掩码等局部编辑方式,并允许把原图与掩码作为两张图输入以保留完整原始信息;在人像与商品场景强化了保真度,编辑前后尽量维持面部特征与商品文字、纹理、形态一致;任务覆盖上,还支持全景图、信息图与分镜图生成。此外,模型在文字排版、人物光影与细节质感上也做了专门优化。
四、旗舰追"实",开源追"省":千问的图像双线
把时间线拉长看,千问的图像模型正在分两条线推进:7 月 21 日发布的旗舰 Qwen-Image-3.0 主打"实",支持最大 4.5k Token 输入、多语言排版与复杂版面生成,面向可落地的生产力场景;而 9 月 20 日开源的 Qwen-Image-2.1 主打"省",把生成、透明与编辑收敛到一个 7B 模型里,面向开发者与创作者的成本敏感场景。据 AI Weekly 报道,该版本的开源许可由此前的 Apache 转为仅限研究用途(research-only),这一点在开源社区引发了讨论——对计划商用的一方来说,授权范围需要在使用前确认清楚。首批生态适配上,Qwen-Image-2.1 已支持 ComfyUI 与 Diffusers,权重同步上线 GitHub、Hugging Face 与 ModelScope。
结语:图像模型的竞争,正在换算法
从"谁的图更好看"到"谁的图更便宜、更好改、更能直接进生产线",图像生成模型的评价标准正在迁移。7B 参数量、原生透明通道、10 张参考图与 2K 原生输出,这套组合未必是跑分意义上的最强,但它指向了一个更现实的问题:当生成能力变得足够便宜,真正稀缺的就只剩下工作流。对内容团队与电商卖家而言,值得关注的不是又多了多少亿参数,而是同样的预算里,能多跑多少张图、少开几个软件。
(本文综合 Qwen 官方博客、Hugging Face、ModelScope、AI Weekly 等公开信息整理,仅供参考。)