
AI热点|达摩院DAMO RADAR登上《科学》:一个模型读懂146种腹部病症,诊断水平首达影像科专家级
 发布时间:2026-09-20
 浏览: 次
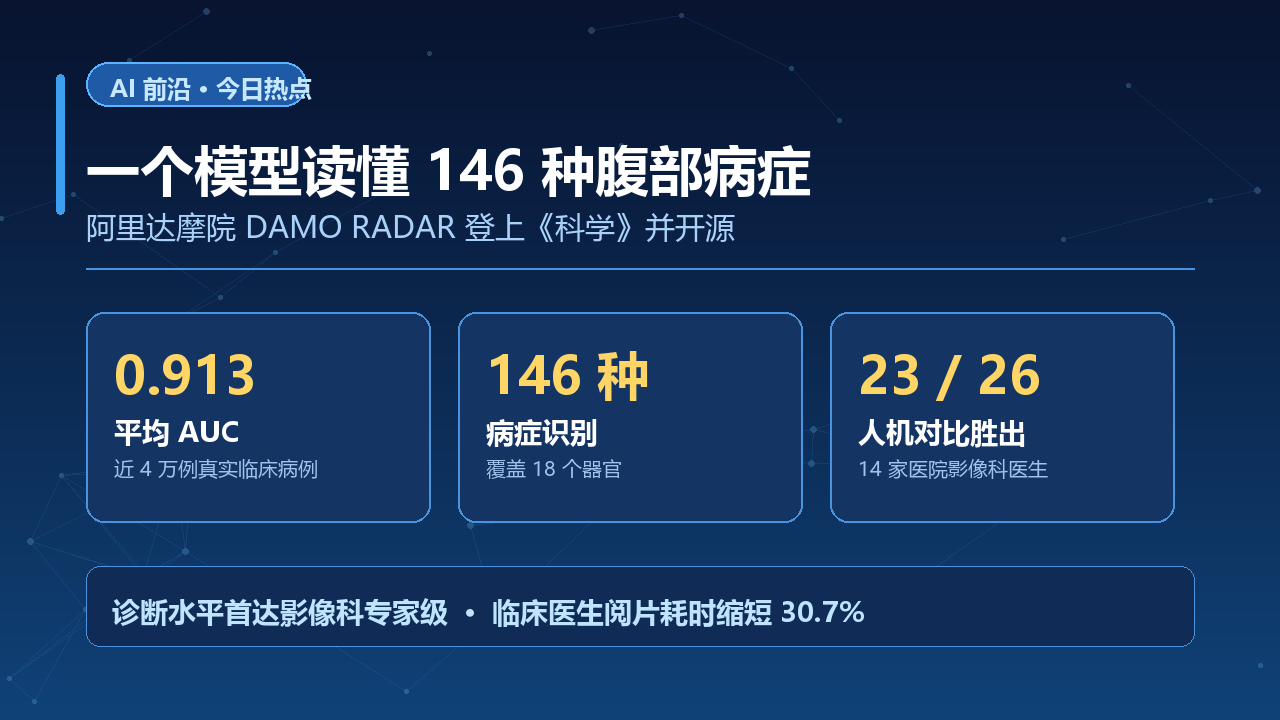
9月18日,阿里巴巴达摩院联合浙江大学医学院附属第一医院等机构研发的通用医疗影像AI模型DAMO RADAR,登上国际顶级学术期刊《科学》(Science),并宣布模型权重、核心代码及全套技术框架全面开源。这是全球首个达到专家级水平的通用医疗影像AI,也意味着医疗影像AI正式从“一病一模”的专病时代,跨入“一个模型读懂多种疾病”的通用时代。
一、腹部CT,为什么被称为“最难读的CT”
在医学影像领域,腹部增强CT长期被认为是难度最高的一类检查。原因在于,一份腹部CT报告需要覆盖消化、泌尿等多个系统的数十个器官,涉及数百种潜在异常;而腹部器官多为软组织,彼此密度相近,病灶与正常组织的边界极其模糊。
浙大一院放射科主任肖文波拥有30余年从业经验,她坦言,即便是中高级医生,完成一份腹部CT报告也需要20分钟到半小时,“年轻医生最怕进的科室组别,就是腹部影像组”。
二、从“一病一模”到“一个模型读懂146种病”
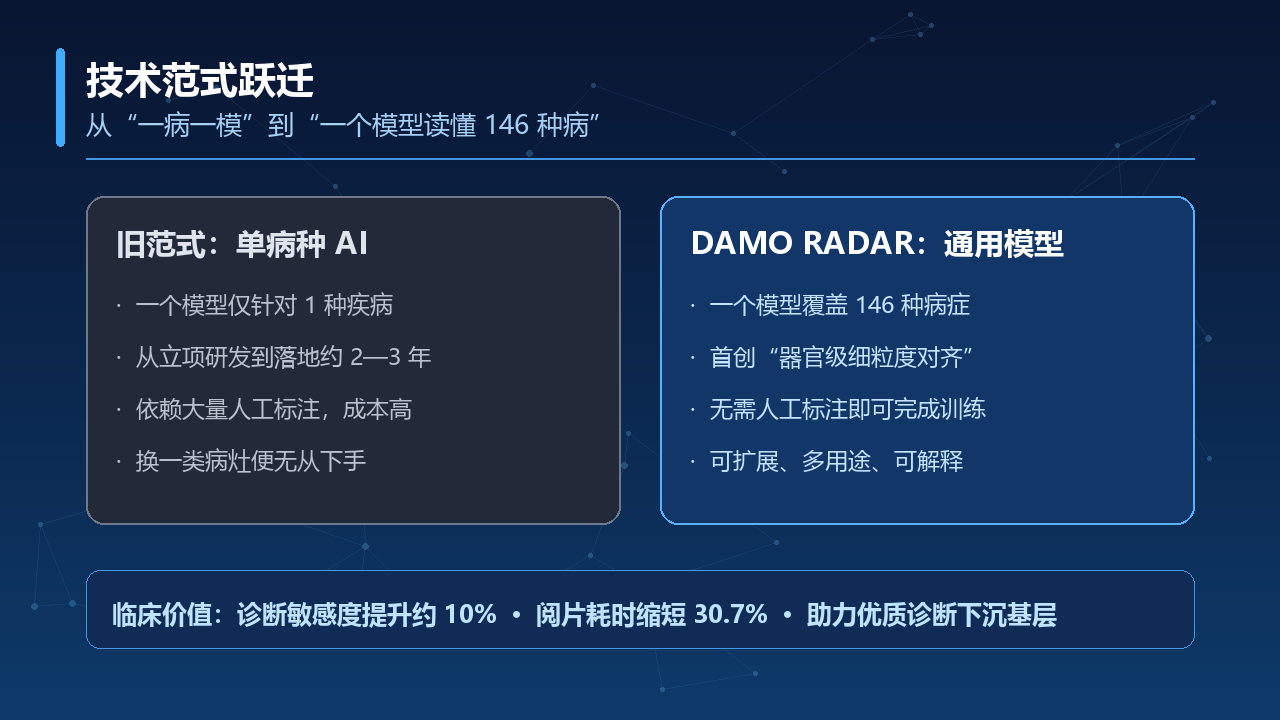
长期以来,医疗影像AI普遍采用“一病一模”的研发模式:一个模型只针对一种疾病开展识别诊断,从立项研发到落地发布往往需要两三年时间。
“单病种AI,就像善攻个别题型的学生,固定题型考试成绩优异,换一类题目便无从下手。”曾主导研发肺癌、肠癌等单病种AI模型的达摩院高级算法专家张建鹏如此形容。
为突破这一瓶颈,达摩院团队另辟蹊径,借鉴放射科医生阅片的真实逻辑——以人体解剖结构为核心,依次核查肝脏、胰腺、胆道等器官。团队在国际上首创“器官级细粒度对齐”技术,将CT三维数据拆解为独立的器官级解剖单元,在器官层面实现影像数据与诊断报告文本的精准对齐,无需人工标注即可完成模型训练,大幅突破了传统技术瓶颈。这一技术路径,也让模型具备了“可扩展、多用途、可解释”的诊断能力。
三、数据说话:AUC 0.913,26名影像科医生中超越23名
DAMO RADAR的验证数据颇具说服力:在近4万例连续临床病例、146种病症(涉及18个器官)的测试中,模型平均AUC(区分患病与健康样本的核心指标,1为完美区分)达到0.913;在覆盖14家医院、26名影像科医生的多中心人机对比试验中,模型的平均诊断准确率超越了其中23名医生;依托该AI辅助,临床医生的诊断敏感度提升约10%,阅片耗时缩短30.7%。
经过第二轮临床验证,模型效果依旧稳定出色。肖文波表示:“这是行业一直渴望实现,却又普遍认为难以达成的AI技术突破。”
四、开源落地:让专家级诊断能力下沉到基层
目前,DAMO RADAR的模型、核心代码及全套技术框架已全面开源。对医疗资源相对薄弱的基层医院而言,这一意义尤为直接——基层医院阅片量有限、医生临床经验相对不足,而腹部CT恰恰是阅片难度最高的环节之一。“希望这款AI能尽快落地基层,助力一线临床诊断。”肖文波说。
结语
从“一个模型只认一种病”,到“一个模型看懂146种病”,DAMO RADAR的价值不只是刷新技术指标,更在于把顶级影像科专家的阅片经验,转化为可复制、可下沉、可开源的通用能力。当医疗AI从“专科工具”进化为“通用专家”,优质医疗资源的边界,也在被重新定义。
(来源综合:光明网、杭州市城乡建设委员会、SCMP等公开报道)